Python requests 怎么接代理IP?先把协议、认证和超时逻辑弄明白
requests 接代理,看起来是一行配置,实际上很多问题都藏在细节里
Python 用户在接入代理IP时,最常用的库之一就是 requests。很多教程会告诉你只需要把代理地址塞进参数里就可以了,但真正使用时,问题通常并不出在“会不会写”,而出在“有没有把协议、认证和异常逻辑配完整”。
因此,学 requests 代理接入时,不建议死背一个固定模板,而是应先理解几个关键点。
第一件事:先明确代理协议
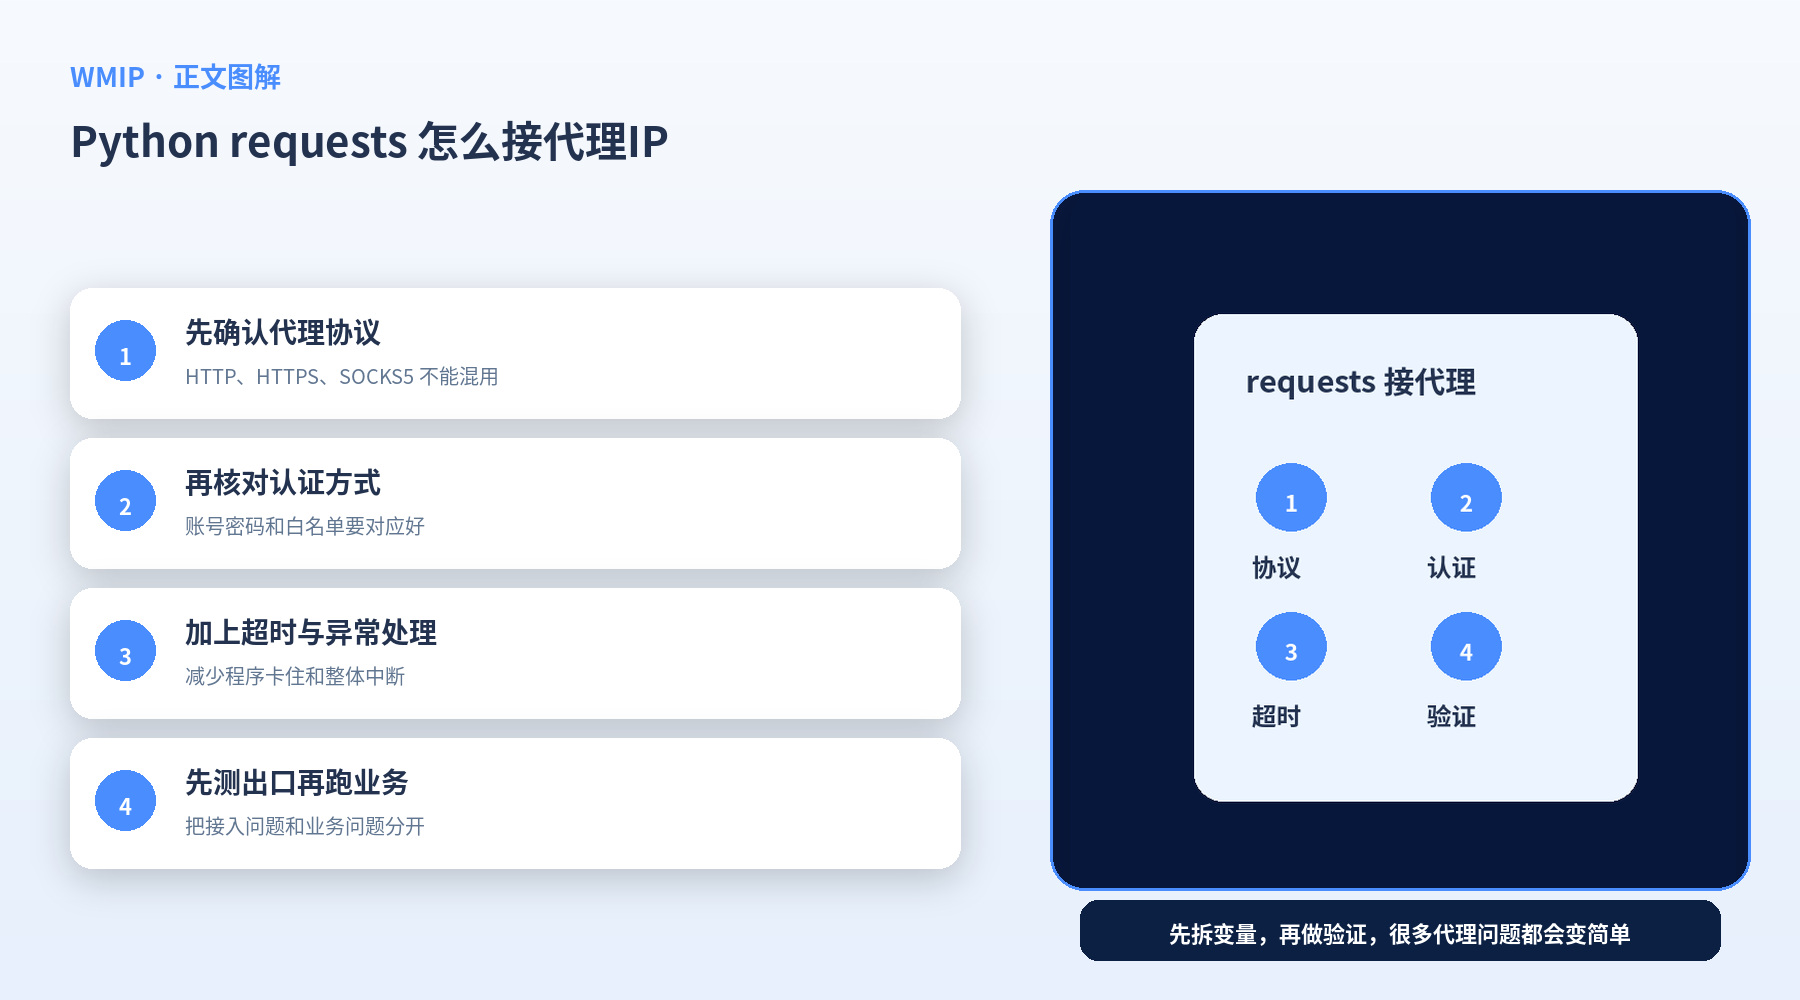
你拿到的资源可能是 HTTP、HTTPS 或 SOCKS5,不同协议的写法和兼容方式不同。如果协议识别错了,看起来像是“代理不通”,其实只是接入方式不对。
第二件事:认证方式要对应正确
有的平台走账号密码,有的平台走白名单,有的平台两种都支持。你需要明确当前资源是哪一种认证模式,再决定程序里应该如何配置。很多“连接失败”其实就是认证路径搞错了。
第三件事:一定要设置超时和异常处理
如果你不设置超时,程序可能长时间卡住;如果不处理异常,少量波动就会让整个流程中断。代理环境天然存在更多网络变量,所以 requests 场景下,超时、重试和异常捕获比直连环境更重要。
为什么建议先做出口检测
在 requests 里,最稳妥的第一步不是直接访问复杂业务接口,而是先访问一个稳定的出口IP检测地址,确认当前请求确实走了代理。这样后面即便真实业务异常,也更容易判断问题到底在代理接入还是在业务本身。
连接通了,不等于业务一定稳定
requests 测试能成功,只能说明程序能够通过代理发出请求。至于目标站是否接受、返回是否稳定、页面结构是否完整,仍然需要结合真实业务去看。
一个更稳妥的实践方式
建议按照“先接入、再检测、再跑业务、最后加异常恢复”的顺序来做,而不是一开始就把代理和复杂业务逻辑混在一起调试。
常见问题
Q:requests 能通,浏览器不通,是不是程序写得更对?
不一定,只是它们使用环境不同,需要分别判断。
Q:是不是只要能返回200就说明代理适合业务?
并不完全,200 只是第一步,还要看真实目标站表现。
总结
requests 接代理真正要掌握的,不是一段固定代码,而是协议、认证、超时和验证顺序。把这几个环节理顺,程序接入会稳定很多。