爬虫任务怎么设计“重试 + 切换代理”策略?不是失败就马上换IP
# 平台指南# 爬虫任务# 代理切换# 重试策略# 代理池
爬虫任务里,失败并不等于立刻换IP。先区分错误类型,再决定重试、延迟还是切换资源,效率会高很多。
相关入口本文涉及的平台、工具或相关页面
前往查看 →
很多爬虫一失败就换代理,看起来积极,实际上常常很低效
做爬虫任务时,程序出现失败是很正常的现象。但不少用户的默认策略是:一报错就立刻换 IP,一超时就马上切节点。表面上好像是在快速恢复,实际上可能让原本可以简单解决的问题变得更复杂,甚至浪费大量资源。
为什么“失败 ≠ 立刻换 IP”?因为失败的原因有很多种。可能是目标站瞬时抖动,可能是程序超时设置过短,可能是请求头异常,也可能真的是当前资源不适合。如果你不区分错误类型,统一粗暴切换代理,排查成本会越来越高。
先分类,再处理
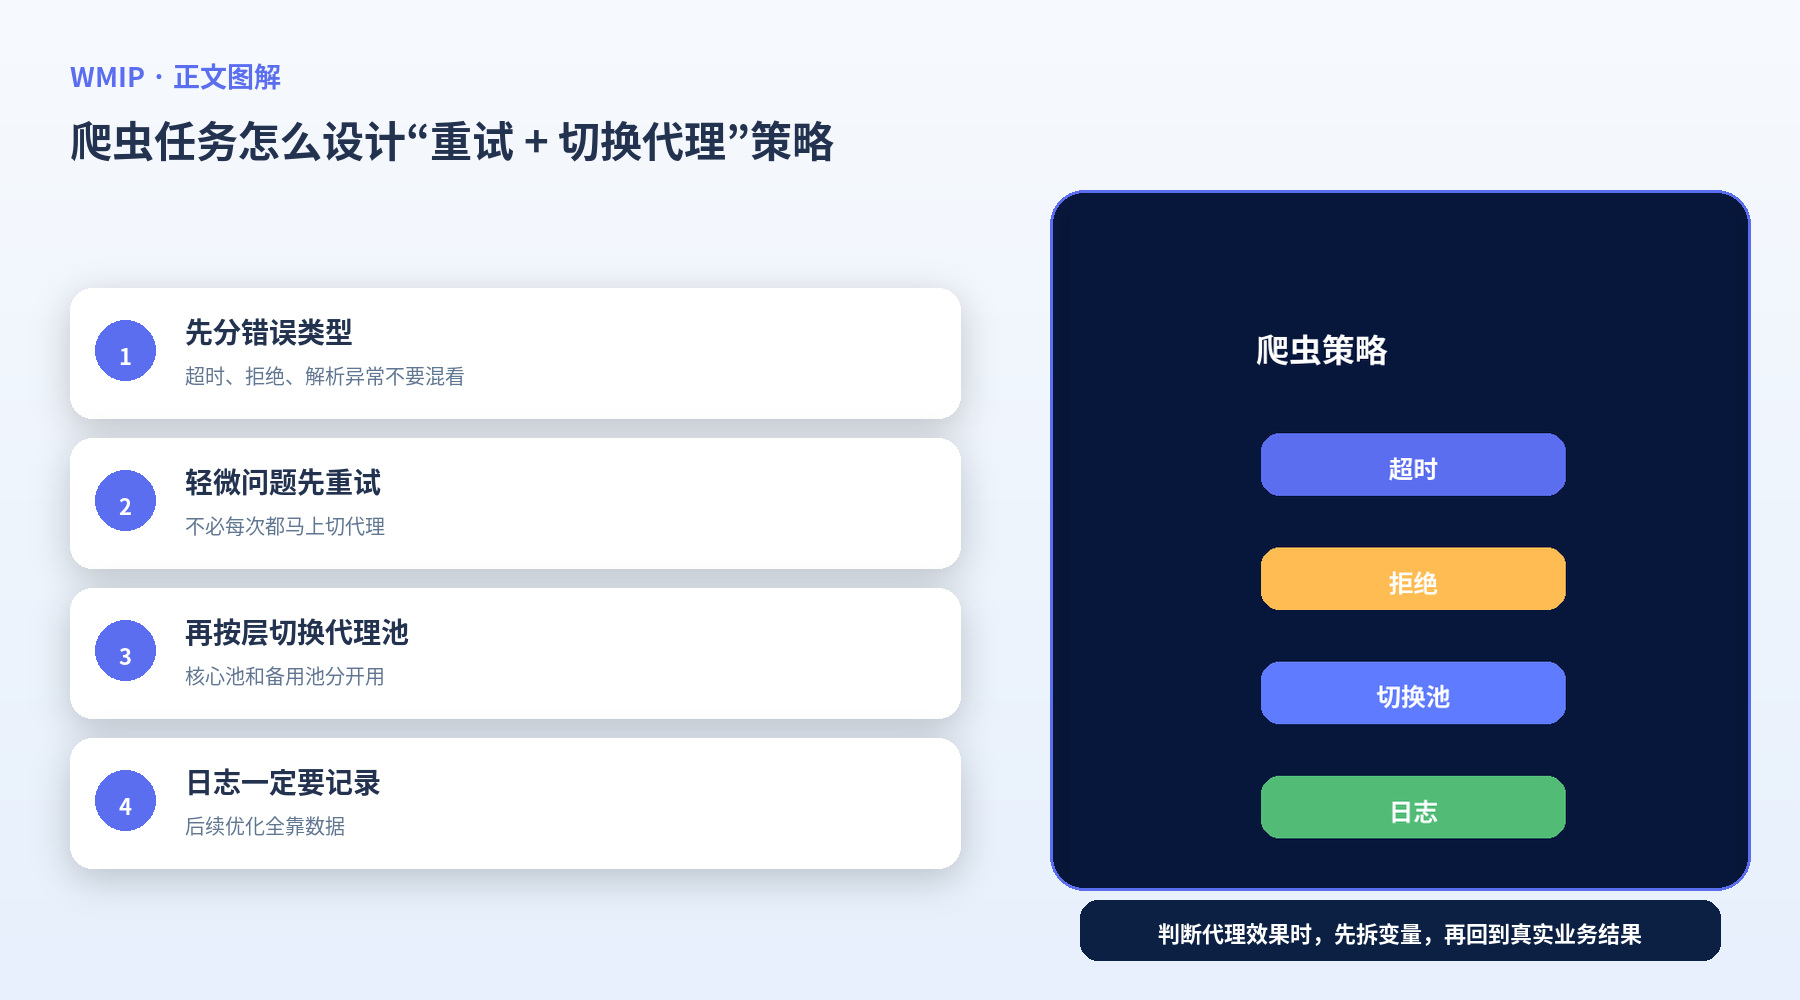
比较合理的做法,是把错误先分成超时类、连接类、目标站拒绝类、解析异常类等。不同类型错误,策略应不同:有的适合原地短延迟重试,有的适合切换资源,有的则应该先停下来检查请求逻辑。
为什么还要控制切换节奏
如果切换过于频繁,你既看不出某类资源是否真的有效,也可能把目标站的访问节奏搞得更不稳定。特别是在大规模任务中,无序切换会让统计和监控变得非常困难。
代理池和重试策略要配套
如果你有核心池、备用池和观察池,那么重试逻辑也应跟着分层:轻微异常先在当前资源内重试,持续异常再切到备用资源,表现差的资源则进入观察池,而不是继续混用。
如何判断该不该切换
可以看同类错误的连续出现次数、同一资源在短时间内的失败率,以及换另一批资源后的对照结果。只有对比出来,你才知道到底该调策略还是换资源。
为什么日志记录不能省
没有日志,你就只能靠印象判断。建议至少记录错误类型、所用代理、请求时间、是否重试以及重试后的结果。这样后面才能真正优化策略。
常见问题
Q:超时是不是最适合立刻换代理?
不一定,先看超时比例和目标站状态,不能一概而论。
Q:重试次数是不是越多越好?
也不是,过度重试会浪费时间和资源。
总结
爬虫任务里的“重试 + 切换代理”策略,关键在于先分错误类型,再做分层处理。比起一失败就换 IP,这种方式更稳也更省资源。
所属知识专题继续按主题查看相关教程与常见问题